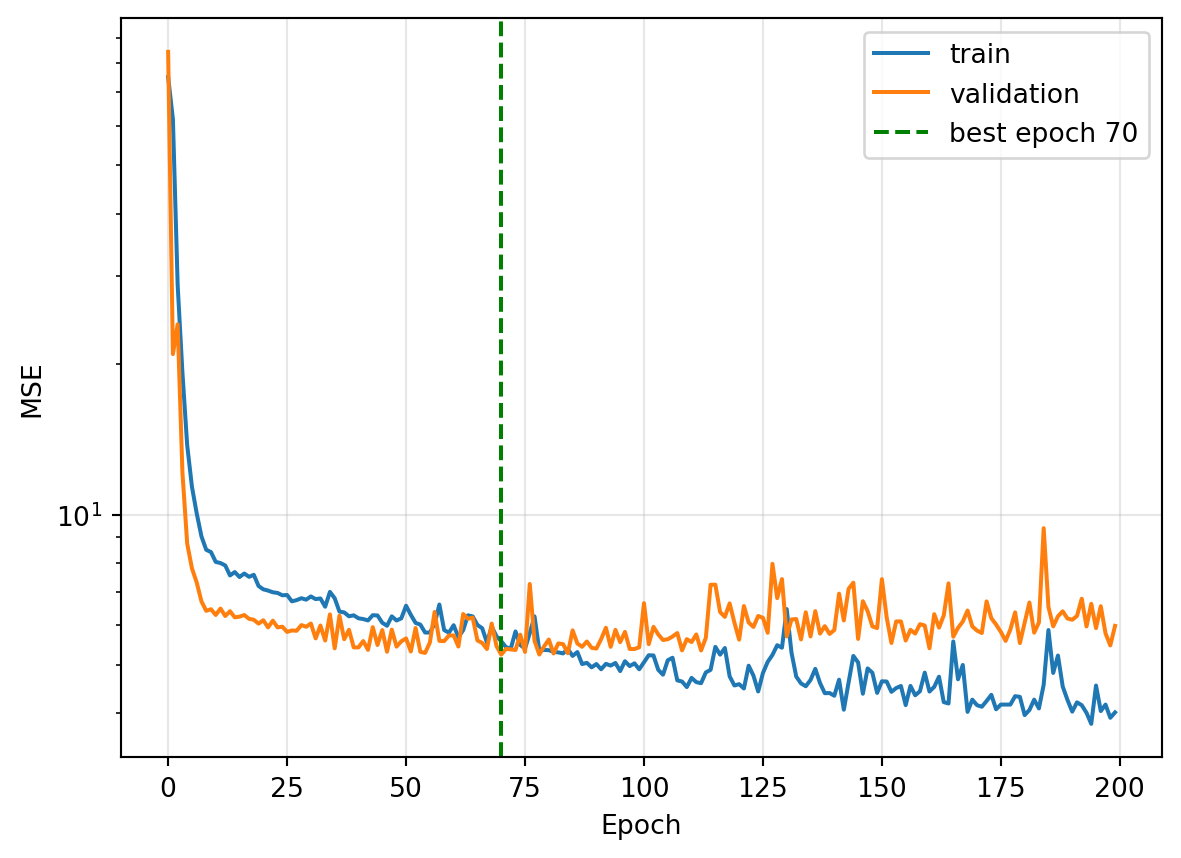
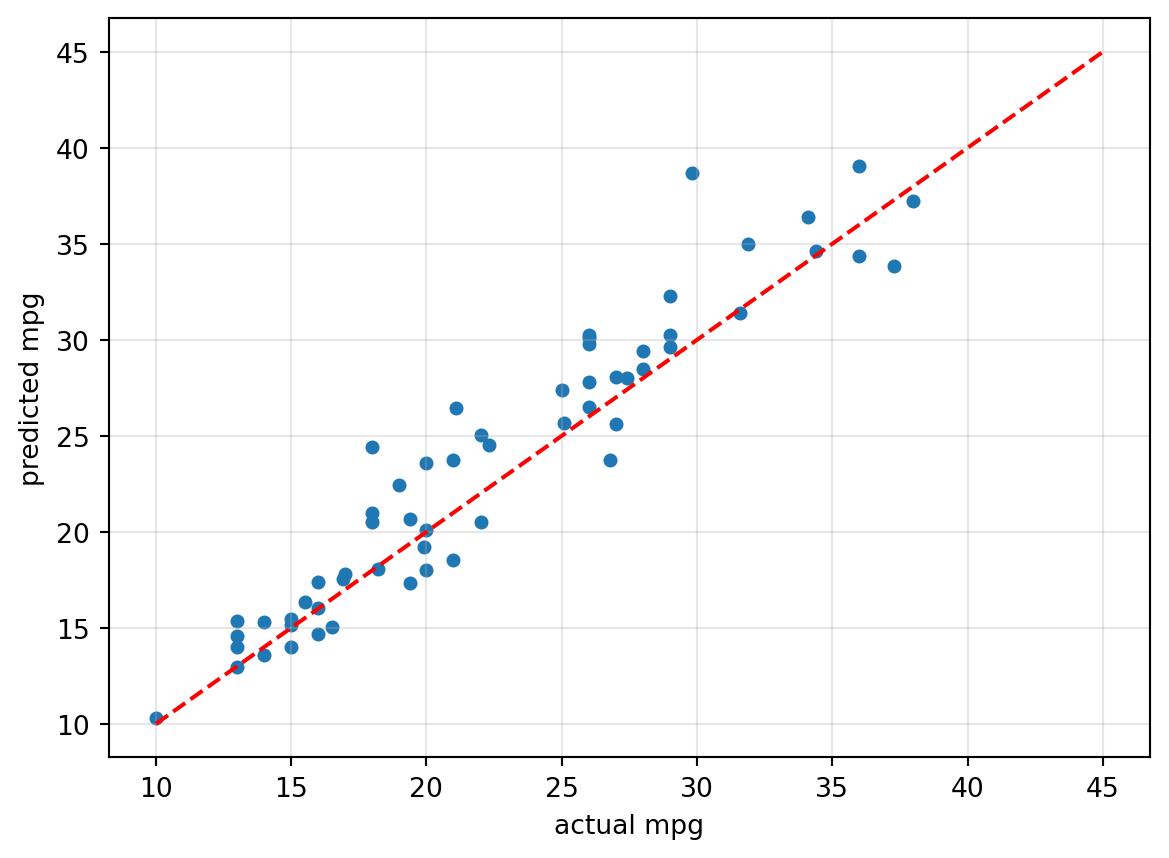
교수자 메모 (실습본에는 없음). 60분 운영: 준비 셀 2분 → 1·2절 모델 준비·다섯 줄·한 에폭 13분 → 3절 평가 함수 8분 → 4절 200 에폭과 러닝커브 10분 → 5절 복사·복원과 조립 12분 → 6절 테스트 5분 → 📝 과제 10분. ✅ 숫자는 각 절의 체크포인트 참조. 테스트 RMSE 약 2.5, 기준선 약 7.1.
# ▶ 준비 셀 — 그대로 실행하세요. 4-1에서 만든 세 세트·전처리·텐서·로더를 다시 만들고, 모델과 손실·갱신 도구를 준비합니다.import pandas as pdimport torchimport torch.nn as nnimport copyfrom sklearn.model_selection import train_test_splitfrom torch.utils.data import TensorDataset, DataLoaderURL ='https://raw.githubusercontent.com/ralbu85/Lecture_DeepLearning_2022/main/auto.csv'auto = pd.read_csv(URL)num_cols = ['cylinders', 'displacement', 'horsepower', 'weight', 'acceleration', 'model_year']train_df, rest_df = train_test_split(auto, test_size=0.3, random_state=42)val_df, test_df = train_test_split(rest_df, test_size=0.5, random_state=42)mu = train_df[num_cols].mean()sd = train_df[num_cols].std(ddof=0)def prep(df): out = df.copy() out[num_cols] = (out[num_cols] - mu) / sd out['origin'] = pd.Categorical(out['origin'], categories=[1, 2, 3])return pd.get_dummies(out, columns=['origin'])def to_tensor(df): X = torch.tensor(df.drop(columns='mpg').to_numpy(dtype='float32')) y = torch.tensor(df[['mpg']].to_numpy(dtype='float32'))return X, yX_tr, y_tr = to_tensor(prep(train_df))X_va, y_va = to_tensor(prep(val_df))X_te, y_te = to_tensor(prep(test_df))train_loader = DataLoader(TensorDataset(X_tr, y_tr), batch_size=32, shuffle=True)val_loader = DataLoader(TensorDataset(X_va, y_va), batch_size=64)test_loader = DataLoader(TensorDataset(X_te, y_te), batch_size=64)print(X_tr.shape, len(train_loader))print("준비 완료!")
torch.Size([274, 9]) 9
준비 완료!
✅ torch.Size([274, 9]) 9와 준비 완료!가 나오면 됩니다.
1. 모델과 도구를 준비하고 배치 하나에 다섯 줄
모델은 실습 3처럼 nn.Sequential로 만듭니다. 입력 9개를 받아 은닉층 32개와 16개를 거쳐 숫자 하나를 냅니다. 손실은 실습 3과 같은 MSELoss입니다. 갱신 도구는 Adam을 씁니다. SGD처럼 기울기의 반대 방향으로 가되 파라미터마다 이동 폭을 스스로 조절합니다. torch.manual_seed(42)는 초기 가중치를 고정합니다.
💬 결과 해설 — 약 658입니다. 다른 32건이므로 손실값이 다릅니다. 배치마다 이렇게 한 번씩 갱신합니다.
2. 모든 배치를 돌면 한 에폭
for로 로더의 배치를 차례로 꺼내 다섯 줄을 실행합니다. 배치 손실은 그 배치의 평균이므로 배치 크기 len(yb)를 곱해 합으로 되돌려 total에 모으고, 건수는 n에 모읍니다. 마지막에 total / n이 에폭의 평균 손실입니다.
# ✍️ 직접 입력total =0.0n =0for xb, yb in train_loader: optimizer.zero_grad() pred = model(xb) loss = criterion(pred, yb) loss.backward() optimizer.step() total += loss.item() *len(yb) n +=len(yb)print(n, total / n)
274 578.8400364339786
💬 결과 해설 — n은 274로 훈련 세트 전체이고, 두 번째 값 약 579이 한 에폭의 평균 훈련 손실입니다.
이 코드를 함수로 조립합니다. 앞에 model.train()을 붙입니다. 모델을 학습 모드로 두는 줄입니다. 빈칸을 채웁니다.
# ✍️ 빈칸(___)을 채운 뒤 실행하세요#* def train_one_epoch(model, loader, criterion, optimizer):#* model.train()#* total = 0.0#* n = 0#* for xb, yb in loader:#* ___ # 이전 기울기 지우기#* pred = ___ # 예측#* loss = ___ # 손실#* ___ # 기울기 계산#* ___ # 가중치 갱신#* total += loss.item() * len(yb)#* n += len(yb)#* return total / n#*#* print(train_one_epoch(model, train_loader, criterion, optimizer))def train_one_epoch(model, loader, criterion, optimizer): model.train() total =0.0 n =0for xb, yb in loader: optimizer.zero_grad() pred = model(xb) loss = criterion(pred, yb) loss.backward() optimizer.step() total += loss.item() *len(yb) n +=len(yb)return total / nprint(train_one_epoch(model, train_loader, criterion, optimizer))
364.2476137258711
💬 결과 해설 — 약 364입니다. 한 에폭을 더 돌아 앞의 값보다 줄었습니다.
3. 검증 손실은 가중치를 바꾸지 않고 잰다
검증 세트로는 손실만 잽니다. 실습 3의 7.3절처럼 torch.no_grad() 안에서 계산합니다. model.eval()은 모델을 평가 모드로 바꿉니다. 드롭아웃처럼 학습과 평가에서 다르게 동작하는 층을 전환하는 줄입니다.
# ✍️ 직접 입력model.eval()with torch.no_grad(): val_loss = criterion(model(X_va), y_va)print(val_loss.item())
154.46697998046875
💬 결과 해설 — 약 154.5입니다. 검증 59건의 평균 손실입니다.
로더로 배치마다 손실을 구해 합치면 같은 값이 나옵니다. 데이터가 커서 한 번에 못 넣을 때는 이렇게 합니다.
# ✍️ 직접 입력total =0.0n =0with torch.no_grad():for xb, yb in val_loader: total += criterion(model(xb), yb).item() *len(yb) n +=len(yb)print(total / n)
154.46697998046875
✅ 체크포인트 — 바로 위와 같은 값이면 맞습니다.
이 코드를 함수로 조립합니다. 빈칸을 채웁니다.
# ✍️ 빈칸(___)을 채운 뒤 실행하세요#* def evaluate(model, loader, criterion):#* model.___()#* total = 0.0#* n = 0#* with torch.___():#* for xb, yb in loader:#* total += criterion(model(xb), yb).item() * len(yb)#* n += len(yb)#* return total / n#*#* print(evaluate(model, val_loader, criterion))def evaluate(model, loader, criterion): model.eval() total =0.0 n =0with torch.no_grad():for xb, yb in loader: total += criterion(model(xb), yb).item() *len(yb) n +=len(yb)return total / nprint(evaluate(model, val_loader, criterion))
154.46697998046875
✅ 체크포인트 — 역시 같은 값이면 맞습니다. 이제 학습 함수와 평가 함수가 갖춰졌습니다.
4. 200 에폭을 돌며 두 손실을 기록한다
에폭마다 두 함수를 한 번씩 부르고, 실습 3의 loss_history처럼 두 손실을 리스트에 기록합니다.