실습 7: 전이학습 — 사진 몇백 장으로 학습시키기

Open In Colab

Open In Colab
시나리오 — 오늘 만들 것

사진이 397장뿐이다. 지난주처럼 처음부터 CNN을 학습시키면 거의 찍기 수준으로 나온다. 오늘은 ImageNet 100만 장으로 이미 학습된 ResNet-18을 빌려 와 같은 데이터를 분류한다.

\[\underbrace{\text{ResNet-18 특성 추출기}}_{\text{얼린다 — 1,100만 개}} \;+\; \underbrace{\text{새 분류기}}_{\text{학습한다 — 1,026개}}\]

세 전략(처음부터 / 동결 / 미세조정)을 같은 데이터로 학습시켜 나란히 비교하고, 전처리를 한 줄 빼먹으면 에러 없이 성능만 떨어지는 것까지 직접 확인한다.

이번 주 실습이 팀 프로젝트에서 그대로 쓰인다. 폴더 구조, 전처리, 동결, 보고 형식까지 여기서 하는 그대로 하면 된다.

이번 주에 익히는 것
개념 이론과의 대응
ImageFolder 내 사진 폴더 → 데이터셋
리사이즈 224 + ImageNet 정규화 반드시 맞춰야 할 두 가지 (Ch08)
데이터 증강, 훈련에만 적용 증강의 금지선 ① (Ch08)
requires_grad = False 동결 (Ch08)
학습 파라미터 수 계산 동결 손계산 (Ch08)
처음부터 vs 동결 vs 미세조정 전이학습 시나리오 판단 (Ch08)
특성 캐싱 실험을 빠르게 돌리는 방법
클래스별 정확도 · 혼동행렬 정확도의 함정 (Ch04, Ch08)

1. 내 사진 폴더를 데이터셋으로 — ImageFolder

프로젝트에서 만들 폴더 구조가 바로 이것이다.

data/
  train/
    ants/   ← 클래스 이름이 곧 폴더 이름
      0013035.jpg ...
    bees/
      ...
  val/
    ants/ ...
    bees/ ...
import os, zipfile, urllib.request
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
from torchvision import datasets, transforms, models
from torch.utils.data import DataLoader, Subset

torch.manual_seed(42); np.random.seed(42)

ROOT = '../data/hymenoptera_data'
if not os.path.isdir(ROOT):
    os.makedirs('../data', exist_ok=True)
    url = 'https://download.pytorch.org/tutorial/hymenoptera_data.zip'
    urllib.request.urlretrieve(url, '../data/hymenoptera_data.zip')
    with zipfile.ZipFile('../data/hymenoptera_data.zip') as z:
        z.extractall('../data')
print(sorted(os.listdir(ROOT)))
['train', 'val']
raw = datasets.ImageFolder(ROOT + '/train')      # transform 없이 먼저 살펴본다
print('클래스        :', raw.classes)
print('클래스→번호   :', raw.class_to_idx)
print('사진 수       :', len(raw))
print('클래스별 장수 :', np.bincount(raw.targets))
클래스        : ['ants', 'bees']
클래스→번호   : {'ants': 0, 'bees': 1}
사진 수       : 244
클래스별 장수 : [123 121]

폴더 이름이 알파벳 순으로 정렬되어 번호가 매겨진다. ants → 0, bees → 1.

for i in [0, 1, 2, 200]:
    img, lab = raw[i]
    print(f'{i:3d}  {img.size}  {raw.classes[lab]}')
  0  (768, 512)  ants
  1  (500, 333)  ants
  2  (500, 282)  ants
200  (500, 364)  bees

크기가 제각각이다. 직접 찍은 사진은 항상 이렇다. 그래서 리사이즈가 필요하다.

직접 해보기 ① — 사진 크기의 분포

raw 의 모든 사진 크기를 조사해 가장 작은 사진과 가장 큰 사진을 찾으시오. 프로젝트에서 직접 찍은 사진도 이렇게 먼저 확인한다.

sizes = None            # ← [(w, h), ...] 리스트를 만드세요

assert sizes is not None and len(sizes) == len(raw)
areas = [w * h for w, h in sizes]
print('가장 작은 :', sizes[int(np.argmin(areas))])
print('가장 큰   :', sizes[int(np.argmax(areas))])
정답 코드 보기
sizes = [raw[i][0].size for i in range(len(raw))]
areas = [w * h for w, h in sizes]
print('가장 작은 :', sizes[int(np.argmin(areas))])
print('가장 큰   :', sizes[int(np.argmax(areas))])
print('평균 가로x세로:', round(np.mean([s[0] for s in sizes])), 'x',
      round(np.mean([s[1] for s in sizes])))
가장 작은 : (193, 130)
가장 큰   : (1488, 1984)
평균 가로x세로: 484 x 385
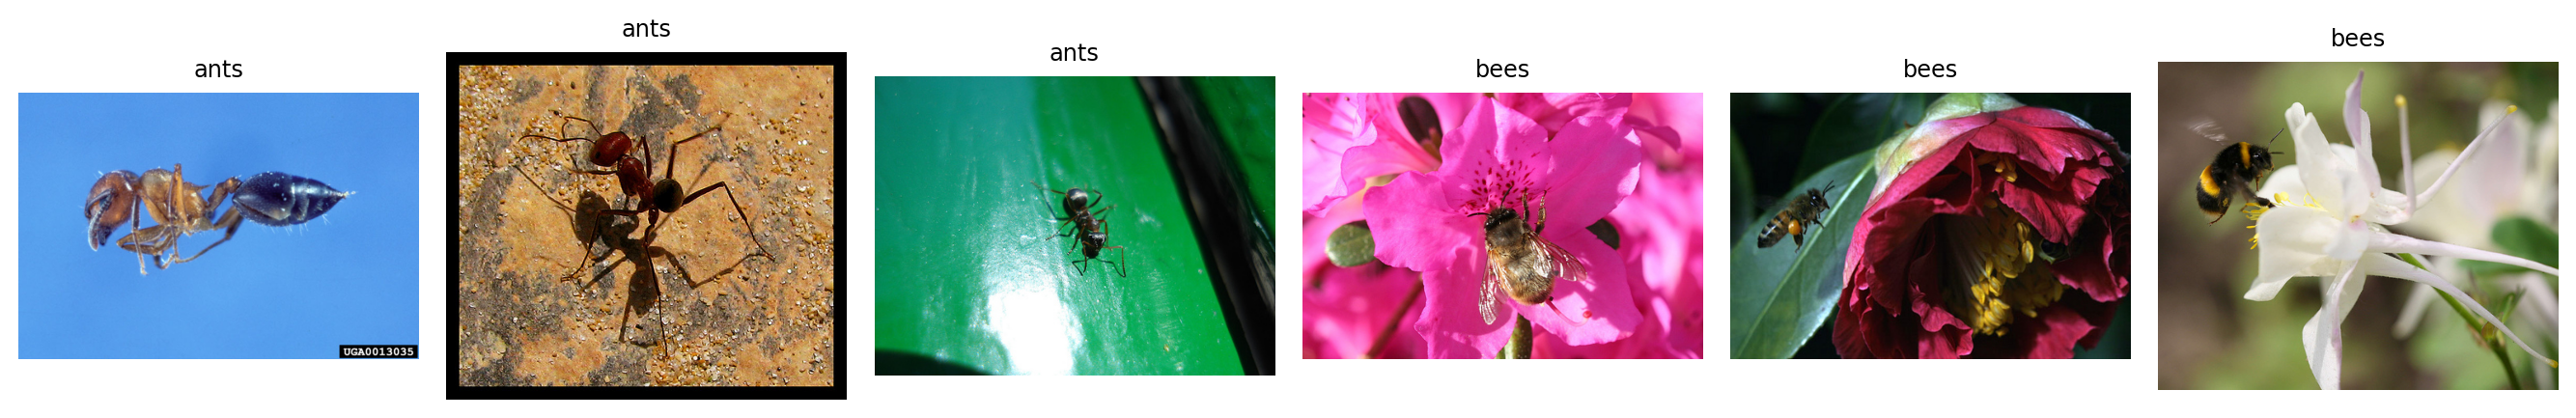
fig, axes = plt.subplots(1, 6, figsize=(14, 2.6))
for ax, i in zip(axes, [0, 40, 80, 130, 180, 230]):
    img, lab = raw[i]
    ax.imshow(img); ax.axis('off'); ax.set_title(raw.classes[lab], fontsize=9)
plt.tight_layout(); plt.show()


2. 전처리 — 사전학습 모델에 맞추기

Ch08의 반드시 맞춰야 할 두 가지를 코드로 옮긴다.

IMAGENET_MEAN = (0.485, 0.456, 0.406)
IMAGENET_STD  = (0.229, 0.224, 0.225)

tf_eval = transforms.Compose([
    transforms.Resize((224, 224)),                       # ① 입력 크기
    transforms.ToTensor(),                               #    CHW + ÷255
    transforms.Normalize(IMAGENET_MEAN, IMAGENET_STD),   # ② 정규화 통계
])

x = tf_eval(raw[0][0])
print('shape :', tuple(x.shape))
print('채널별 평균:', x.mean(dim=(1, 2)).numpy().round(3))
print('전체 범위 :', round(float(x.min()), 3), '~', round(float(x.max()), 3))
shape : (3, 224, 224)
채널별 평균: [-0.612  0.545  1.987]
전체 범위 : -2.118 ~ 2.588
이 두 줄을 빼먹으면 에러 없이 성능만 떨어진다
  • 입력 크기 224 — 사전학습 모델이 학습한 크기다.
  • ImageNet 통계 — 내 사진으로 평균을 다시 구하는 것이 아니라, 모델이 학습할 때 쓴 상수를 그대로 가져다 쓴다. 모델이 학습한 좌표계에 입력을 맞추는 것이다.

8절에서 이 값을 빼먹으면 어떻게 되는지 직접 확인한다.


3. 분할 — 훈련 / 검증 / 테스트

이 데이터셋은 train 과 val 두 폴더로 나뉘어 있다. train 폴더를 다시 훈련/검증으로 나누고, val 폴더는 테스트로 남긴다.

from sklearn.model_selection import train_test_split

y = np.array(raw.targets)
tr_idx, va_idx = train_test_split(
    np.arange(len(y)), test_size=0.25, random_state=42, stratify=y)

print('훈련 :', len(tr_idx), np.bincount(y[tr_idx]))
print('검증 :', len(va_idx), np.bincount(y[va_idx]))

test_ds = datasets.ImageFolder(ROOT + '/val', transform=tf_eval)
print('테스트:', len(test_ds), np.bincount(np.array(test_ds.targets)))
훈련 : 183 [92 91]
검증 : 61 [31 30]
테스트: 153 [70 83]
테스트 세트는 10절에서 딱 한 번만 사용한다

중간에 테스트 정확도를 보고 하이퍼파라미터를 고르면, 그 순간부터 테스트 세트는 검증 세트가 된다. 모든 선택은 검증 세트로만 한다.


4. 데이터 증강

4-1. 증강은 훈련 세트에만

tf_aug = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.7, 1.0)),
    transforms.RandomHorizontalFlip(),
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    transforms.ToTensor(),
    transforms.Normalize(IMAGENET_MEAN, IMAGENET_STD),
])
증강의 두 금지선 (Ch08)

① 증강은 훈련 데이터에만. 검증·테스트에는 tf_eval 만 쓴다. 검증 데이터가 매번 바뀌면 성능 비교 자체가 불가능해진다.

② 레이블이 바뀌는 변형은 금지. 숫자 6을 180도 돌리면 9가 된다. 좌우 반전이 안전한지는 데이터마다 다르다 — 글자·표지판은 위험하다.

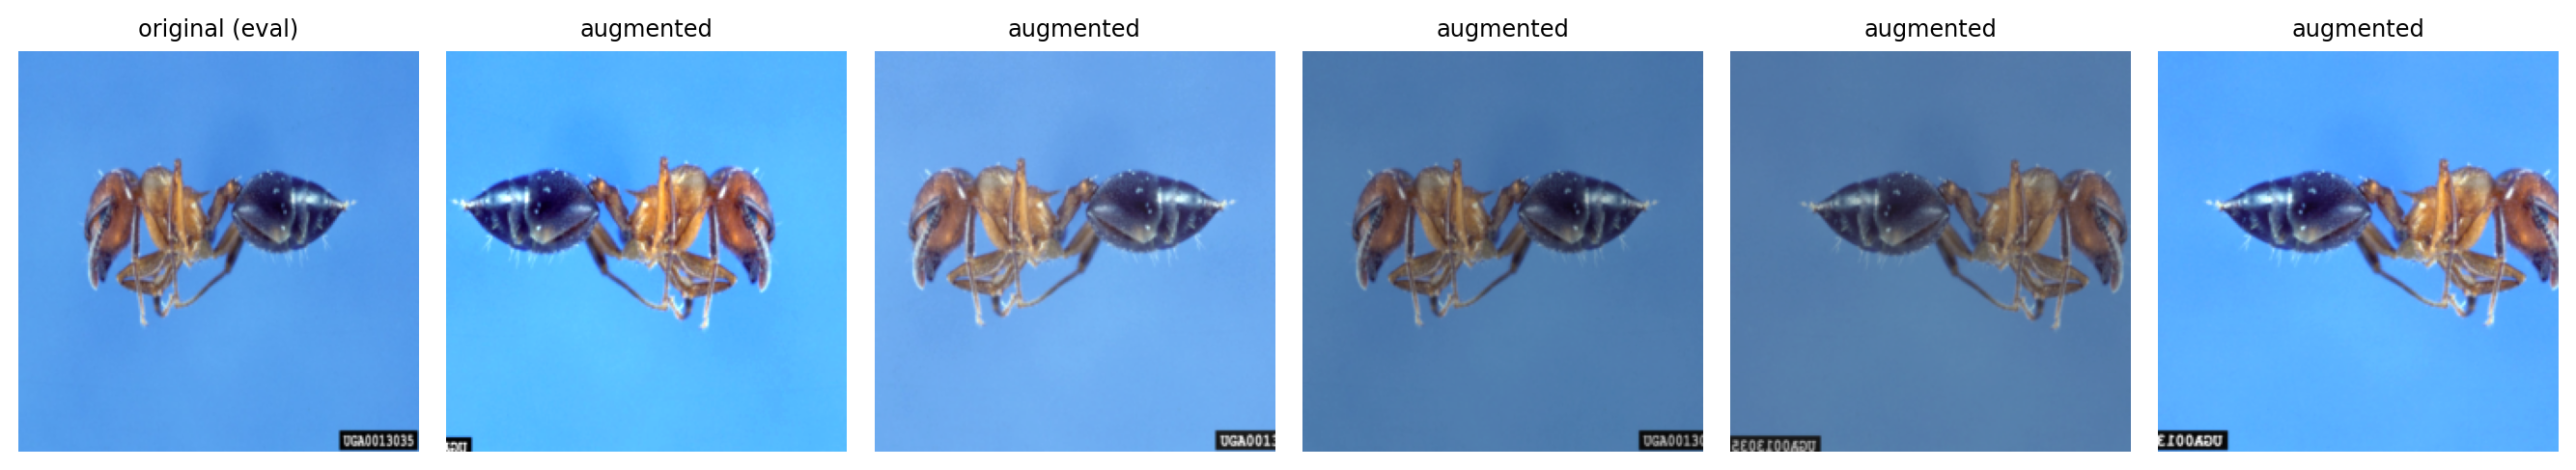
4-2. 같은 사진에 증강을 여러 번 적용해 본다

def unnorm(t):
    m = np.array(IMAGENET_MEAN); s = np.array(IMAGENET_STD)
    return (t.permute(1, 2, 0).numpy() * s + m).clip(0, 1)

src = raw[0][0]
fig, axes = plt.subplots(1, 6, figsize=(14, 2.6))
axes[0].imshow(unnorm(tf_eval(src))); axes[0].set_title('original (eval)', fontsize=9)
for ax in axes[1:]:
    ax.imshow(unnorm(tf_aug(src))); ax.set_title('augmented', fontsize=9)
for ax in axes: ax.axis('off')
plt.tight_layout(); plt.show()

같은 사진 한 장에서 매번 다른 그림이 나온다. 데이터가 부풀려지는 것이 아니라 모델이 매 에폭 조금씩 다른 것을 보게 되는 것이다.

4-3. 데이터로더

def make_loaders(aug=True, batch_size=32):
    tf_tr = tf_aug if aug else tf_eval
    ds_tr = Subset(datasets.ImageFolder(ROOT + '/train', transform=tf_tr), tr_idx)
    ds_va = Subset(datasets.ImageFolder(ROOT + '/train', transform=tf_eval), va_idx)
    return (DataLoader(ds_tr, batch_size=batch_size, shuffle=True),
            DataLoader(ds_va, batch_size=64),
            DataLoader(test_ds, batch_size=64))

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print('device :', device)
device : cuda

5. 사전학습 모델 열어보기

resnet = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)

def n_params(m, only_trainable=False):
    ps = m.parameters()
    return sum(p.numel() for p in ps if (p.requires_grad or not only_trainable))

print('전체 파라미터 :', f'{n_params(resnet):,}')
print('마지막 층     :', resnet.fc)
print('특성 벡터 길이:', resnet.fc.in_features)
전체 파라미터 : 11,689,512
마지막 층     : Linear(in_features=512, out_features=1000, bias=True)
특성 벡터 길이: 512

fc 바로 앞이 GAP이다. Ch07에서 본 그대로 — 마지막 특성 맵을 채널마다 평균 하나로 줄여 512개의 숫자로 만든 뒤, 그것을 1000개 클래스로 분류한다.

h = torch.zeros(1, 3, 224, 224)
for name, layer in list(resnet.named_children()):
    h = layer(h) if name != 'fc' else layer(h.flatten(1))
    print(f'{name:9s} → {tuple(h.shape[1:])}')
conv1     → (64, 112, 112)
bn1       → (64, 112, 112)
relu      → (64, 112, 112)
maxpool   → (64, 56, 56)
layer1    → (64, 56, 56)
layer2    → (128, 28, 28)
layer3    → (256, 14, 14)
layer4    → (512, 7, 7)
avgpool   → (512, 1, 1)
fc        → (1000,)

6. 분류기 교체와 동결

6-1. 동결 = requires_grad = False

def build_frozen(n_classes=2):
    m = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
    for p in m.parameters():
        p.requires_grad = False              # 전부 얼린다
    m.fc = nn.Linear(m.fc.in_features, n_classes)   # 새로 만든 층은 requires_grad=True
    return m

frozen = build_frozen()
total     = sum(p.numel() for p in frozen.parameters())
trainable = sum(p.numel() for p in frozen.parameters() if p.requires_grad)
print('전체 파라미터   :', f'{total:,}')
print('학습되는 파라미터:', f'{trainable:,}')
print('공식 512*2+2    :', 512*2 + 2)
print('비율            :', f'{100*trainable/total:.4f}%')
전체 파라미터   : 11,177,538
학습되는 파라미터: 1,026
공식 512*2+2    : 1026
비율            : 0.0092%

6-2. Ch08의 손계산을 코드로 — ResNet-50, 7클래스

r50 = models.resnet50(weights=None)          # 가중치는 필요 없다, 구조만 센다
total50 = sum(p.numel() for p in r50.parameters())
head = 2048 * 7 + 7
print('ResNet-50 전체 :', f'{total50:,}')
print('새 분류기      :', f'{head:,}', ' = 2048*7+7')
print('비율           :', f'{100*head/total50:.3f}%')
ResNet-50 전체 : 25,557,032
새 분류기      : 14,343  = 2048*7+7
비율           : 0.056%

이론에서 손으로 구한 14,343개, 0.06% 미만과 같다.

직접 해보기 ② — 클래스 수를 바꾸면

프로젝트는 클래스가 3~5개다. ResNet-18을 동결하고 클래스 4개로 분류할 때 학습되는 파라미터 수를 먼저 계산한 뒤 확인하시오.

my_answer = None        # ← 예상 파라미터 수

m4 = build_frozen(n_classes=4)
real = sum(p.numel() for p in m4.parameters() if p.requires_grad)
assert my_answer == real, f'다릅니다. 실제 {real} — 공식은 512 x 클래스수 + 클래스수'
print('통과', real)
정답 코드 보기
my_answer = 512 * 4 + 4
m4 = build_frozen(n_classes=4)
real = sum(p.numel() for p in m4.parameters() if p.requires_grad)
print('공식 512x4+4 =', my_answer, '  실제 =', real)
공식 512x4+4 = 2052   실제 = 2052

6-3. 층별로 얼마나 얼었는지 확인

rows = []
for name, module in frozen.named_children():
    tot = sum(p.numel() for p in module.parameters())
    tra = sum(p.numel() for p in module.parameters() if p.requires_grad)
    if tot > 0:
        rows.append({'블록': name, '파라미터': f'{tot:,}', '학습 대상': f'{tra:,}'})
print(pd.DataFrame(rows).to_string(index=False))
    블록      파라미터 학습 대상
 conv1     9,408     0
   bn1       128     0
layer1   147,968     0
layer2   525,568     0
layer3 2,099,712     0
layer4 8,393,728     0
    fc     1,026 1,026

7. 세 가지 전략을 비교한다

같은 데이터, 같은 학습 루프, 모델만 바꾼다.

import copy, time

def run_epoch(model, loader, criterion, optimizer=None):
    train_mode = optimizer is not None
    model.train() if train_mode else model.eval()
    total, correct, n = 0.0, 0, 0
    with torch.set_grad_enabled(train_mode):
        for xb, yb in loader:
            xb, yb = xb.to(device), yb.to(device)
            logits = model(xb)
            loss = criterion(logits, yb)
            if train_mode:
                optimizer.zero_grad(); loss.backward(); optimizer.step()
            total += loss.item() * len(yb)
            correct += (logits.argmax(1) == yb).sum().item()
            n += len(yb)
    return total / n, correct / n


def fit(model, loaders, lr, epochs=8, tag=''):
    tr_loader, va_loader, _ = loaders
    model = model.to(device)
    criterion = nn.CrossEntropyLoss()
    params = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.Adam(params, lr=lr)
    hist = {'tr': [], 'va': [], 'va_acc': []}
    best = (float('inf'), None, 0)
    t0 = time.time()
    for ep in range(epochs):
        trl, _ = run_epoch(model, tr_loader, criterion, optimizer)
        val, vaa = run_epoch(model, va_loader, criterion)
        hist['tr'].append(trl); hist['va'].append(val); hist['va_acc'].append(vaa)
        if val < best[0]:
            best = (val, copy.deepcopy(model.state_dict()), ep)
    model.load_state_dict(best[1])
    print(f'{tag:24s} best epoch {best[2]:2d}  val acc {hist["va_acc"][best[2]]:.4f}  '
          f'({time.time()-t0:.0f}s, 학습 파라미터 {sum(p.numel() for p in params):,})')
    return model, hist, best[2]

7-1. 처음부터 학습하는 작은 CNN

class SmallCNN(nn.Module):
    def __init__(self, n_classes=2):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.AdaptiveAvgPool2d(1), nn.Flatten())
        self.head = nn.Linear(64, n_classes)
    def forward(self, x):
        return self.head(self.features(x))

torch.manual_seed(42)
loaders_aug = make_loaders(aug=True)
m_scratch, h_scratch, b_scratch = fit(SmallCNN(), loaders_aug, lr=1e-3, tag='처음부터 (SmallCNN)')
처음부터 (SmallCNN)          best epoch  5  val acc 0.5574  (19s, 학습 파라미터 23,714)

7-2. 동결 전이학습

torch.manual_seed(42)
m_frozen, h_frozen, b_frozen = fit(build_frozen(), loaders_aug, lr=1e-3, tag='동결 (ResNet-18)')
동결 (ResNet-18)           best epoch  6  val acc 0.9508  (19s, 학습 파라미터 1,026)

7-3. 전체 미세조정 (학습률을 작게)

def build_finetune(n_classes=2):
    m = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
    m.fc = nn.Linear(m.fc.in_features, n_classes)
    return m

torch.manual_seed(42)
m_ft, h_ft, b_ft = fit(build_finetune(), loaders_aug, lr=1e-4, tag='미세조정 lr=1e-4')
미세조정 lr=1e-4             best epoch  5  val acc 0.9344  (19s, 학습 파라미터 11,177,538)

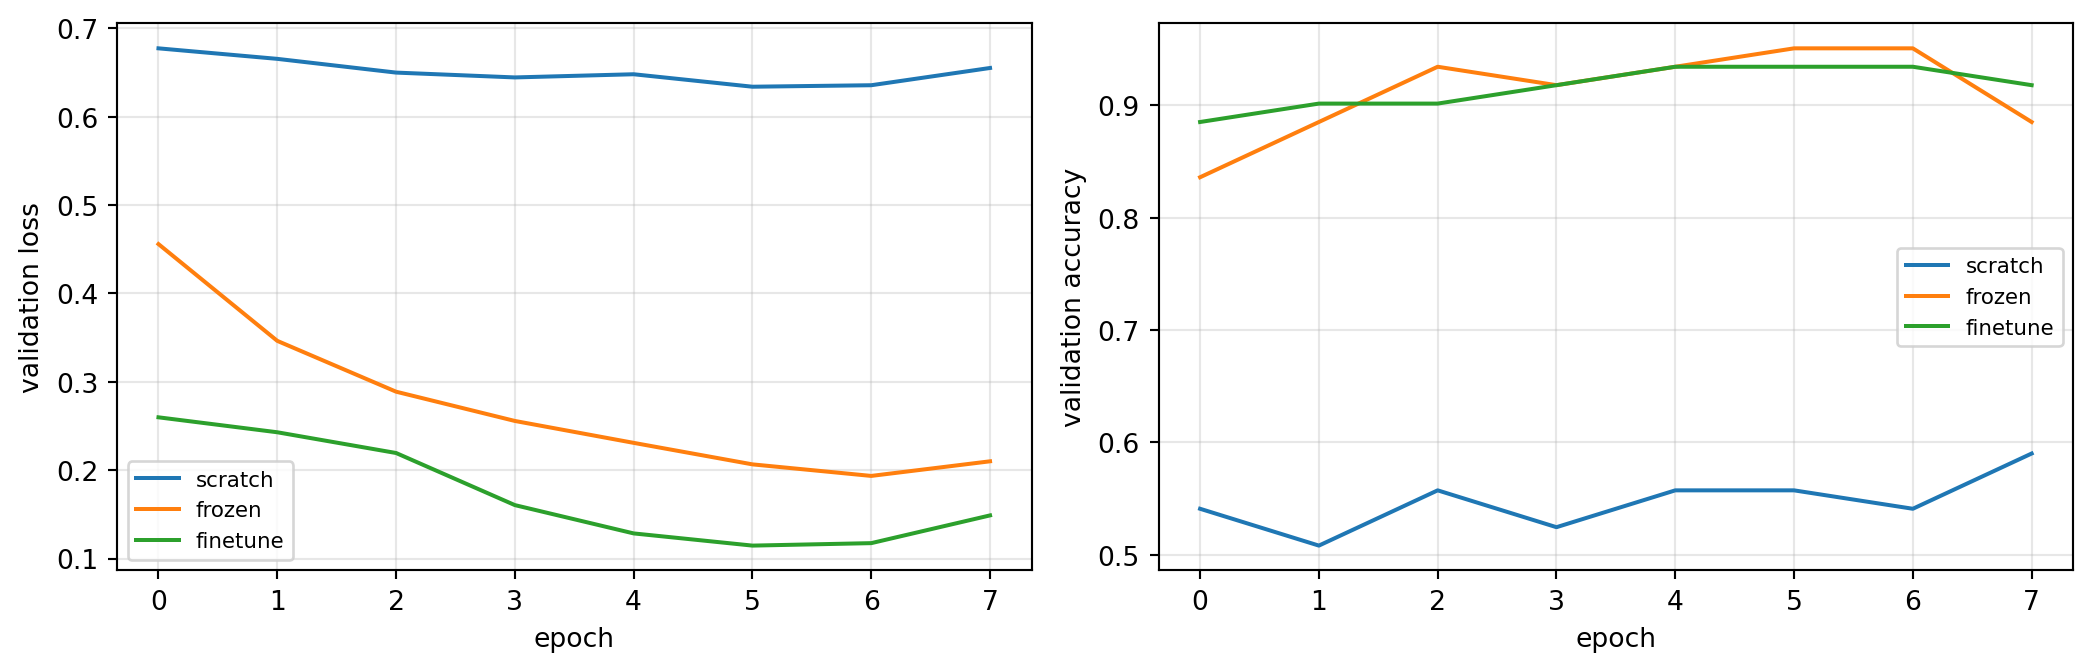
7-4. 학습커브를 겹쳐 본다

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
for name, h in [('scratch', h_scratch), ('frozen', h_frozen), ('finetune', h_ft)]:
    axes[0].plot(h['va'], label=name)
    axes[1].plot(h['va_acc'], label=name)
axes[0].set_ylabel('validation loss'); axes[1].set_ylabel('validation accuracy')
for ax in axes:
    ax.set_xlabel('epoch'); ax.grid(alpha=0.3); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()

summary = pd.DataFrame([
    {'전략': '처음부터 (SmallCNN)', '학습 파라미터': f'{n_params(SmallCNN(), True):,}',
     '최고 검증 정확도': round(max(h_scratch['va_acc']), 4)},
    {'전략': '동결 (ResNet-18)', '학습 파라미터': f'{512*2+2:,}',
     '최고 검증 정확도': round(max(h_frozen['va_acc']), 4)},
    {'전략': '미세조정 (ResNet-18)', '학습 파라미터': f'{n_params(build_finetune(), True):,}',
     '최고 검증 정확도': round(max(h_ft['va_acc']), 4)},
])
print(summary.to_string(index=False))
              전략    학습 파라미터  최고 검증 정확도
 처음부터 (SmallCNN)     23,714     0.5902
  동결 (ResNet-18)      1,026     0.9508
미세조정 (ResNet-18) 11,177,538     0.9344

위 학습 로그의 val acc 는 검증 손실이 가장 낮았던 에폭의 정확도이고, 표의 최고 검증 정확도 는 전 구간 최고값이다. 조기 종료는 손실을 기준으로 하므로 두 값이 다를 수 있다 — 어느 기준으로 골랐는지 항상 밝혀야 한다.

사진이 183장뿐이다. 처음부터 학습하는 모델에게는 턱없이 부족한 양이지만, ImageNet 100만 장에서 배운 특성 추출기를 빌려 오면 분류기 1,026개만 학습해도 된다.


8. 특성 캐싱 — 동결이면 특성은 한 번만 뽑으면 된다

동결 전이학습에서는 특성 추출기가 전혀 변하지 않는다. 그런데도 매 에폭 같은 사진을 같은 ResNet에 통과시키고 있다. 낭비다.

특성을 한 번만 뽑아 저장해 두면, 그다음은 512차원 벡터로 하는 선형 분류일 뿐이다.

@torch.no_grad()
def extract_features(backbone, loader):
    backbone.eval()
    feats, labels = [], []
    for xb, yb in loader:
        feats.append(backbone(xb.to(device)).flatten(1).cpu())
        labels.append(yb)
    return torch.cat(feats), torch.cat(labels)

# fc를 항등 함수로 바꾸면 512차원 특성이 그대로 나온다
backbone = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
backbone.fc = nn.Identity()
backbone = backbone.to(device)

# 캐싱할 때는 증강을 끈다 (증강하면 매번 특성이 달라져 캐싱이 무의미해진다)
loaders_noaug = make_loaders(aug=False)
t0 = time.time()
Ftr, ytr = extract_features(backbone, loaders_noaug[0])
Fva, yva = extract_features(backbone, loaders_noaug[1])
Fte, yte = extract_features(backbone, loaders_noaug[2])
print(f'특성 추출 {time.time()-t0:.1f}초')
print('훈련 특성 :', tuple(Ftr.shape), '  검증 :', tuple(Fva.shape), '  테스트 :', tuple(Fte.shape))
특성 추출 3.2초
훈련 특성 : (183, 512)   검증 : (61, 512)   테스트 : (153, 512)
def fit_head(Ftr, ytr, Fva, yva, epochs=200, lr=1e-2, seed=42):
    torch.manual_seed(seed)
    head = nn.Linear(Ftr.shape[1], 2)
    opt = torch.optim.Adam(head.parameters(), lr=lr)
    crit = nn.CrossEntropyLoss()
    best = (float('inf'), None, 0)
    for ep in range(epochs):
        head.train(); opt.zero_grad()
        loss = crit(head(Ftr), ytr); loss.backward(); opt.step()
        head.eval()
        with torch.no_grad():
            vl = crit(head(Fva), yva).item()
        if vl < best[0]:
            best = (vl, copy.deepcopy(head.state_dict()), ep)
    head.load_state_dict(best[1])
    with torch.no_grad():
        acc = (head(Fva).argmax(1) == yva).float().mean().item()
    return head, acc, best[2]

t0 = time.time()
head, acc_cached, ep_cached = fit_head(Ftr, ytr, Fva, yva)
print(f'캐싱 후 200에폭 학습: {time.time()-t0:.1f}초')
print(f'검증 정확도 {acc_cached:.4f} (최적 에폭 {ep_cached})')
캐싱 후 200에폭 학습: 0.2초
검증 정확도 1.0000 (최적 에폭 35)
프로젝트에서 이 방법을 쓰게 된다

동결 전략으로 실험을 여러 번 돌려야 할 때(클래스 조합 바꾸기, 분류기 크기 바꾸기, 데이터 추가하기) 특성을 한 번 뽑아 두면 이후 실험이 몇 초 만에 끝난다.

단, 증강을 쓰면 캐싱할 수 없다 — 매 에폭 이미지가 달라지므로 특성도 달라진다. 증강이 필요하면 매번 통과시켜야 한다.


9. 조용히 망가지는 지점 — 정규화 통계를 빼먹으면

캐싱 덕분에 이 실험을 몇 초 만에 할 수 있다. 정규화만 빼고 특성을 다시 뽑는다.

tf_nonorm = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),                 # Normalize 없음
])

def loaders_with(tf):
    d_tr = Subset(datasets.ImageFolder(ROOT + '/train', transform=tf), tr_idx)
    d_va = Subset(datasets.ImageFolder(ROOT + '/train', transform=tf), va_idx)
    return DataLoader(d_tr, batch_size=64), DataLoader(d_va, batch_size=64)

l_tr, l_va = loaders_with(tf_nonorm)
Ftr2, ytr2 = extract_features(backbone, l_tr)
Fva2, yva2 = extract_features(backbone, l_va)
_, acc_nonorm, _ = fit_head(Ftr2, ytr2, Fva2, yva2)

print(f'정규화 있음 : 검증 정확도 {acc_cached:.4f}')
print(f'정규화 없음 : 검증 정확도 {acc_nonorm:.4f}')
print(f'차이        : {acc_cached - acc_nonorm:+.4f}')
정규화 있음 : 검증 정확도 1.0000
정규화 없음 : 검증 정확도 0.9180
차이        : +0.0820

에러는 하나도 나지 않았다. 코드는 멀쩡히 돌았고 정확도만 달라졌다. 사전학습 모델을 쓸 때 그 모델이 요구하는 전처리를 문서에서 확인해야 하는 이유다.

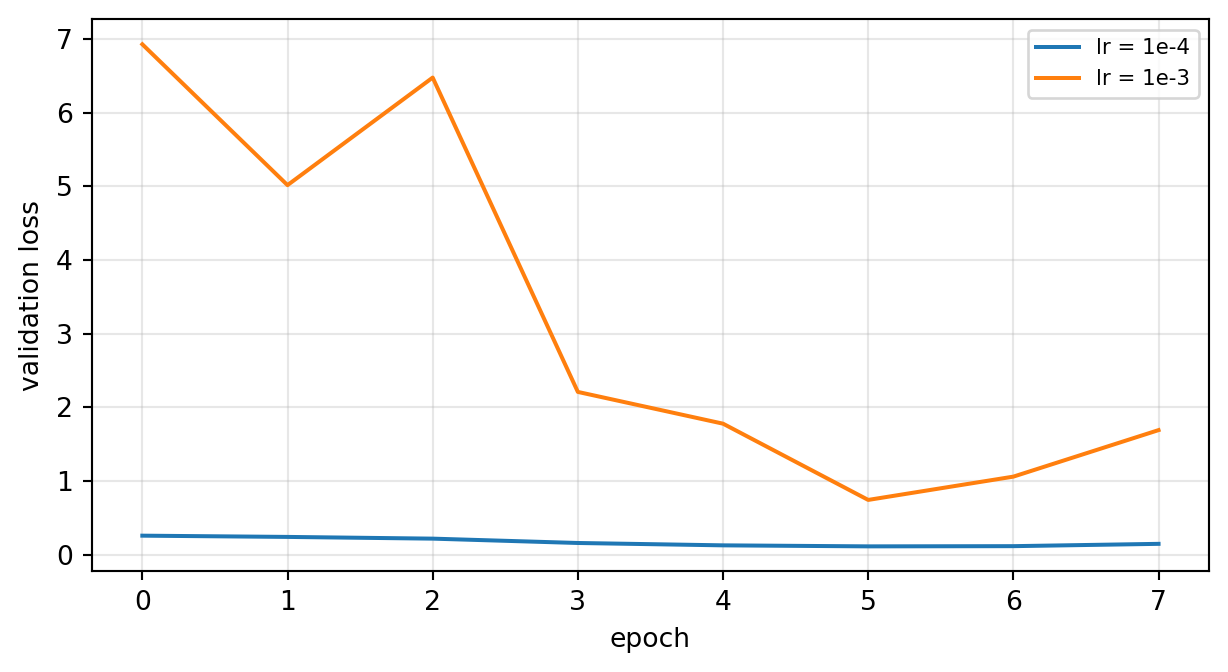
9-1. 미세조정 학습률 — 큰 값을 쓰면

torch.manual_seed(42)
_, h_ft_big, _ = fit(build_finetune(), loaders_aug, lr=1e-3, epochs=8, tag='미세조정 lr=1e-3')

plt.figure(figsize=(6.5, 3.6))
plt.plot(h_ft['va'], label='lr = 1e-4')
plt.plot(h_ft_big['va'], label='lr = 1e-3')
plt.xlabel('epoch'); plt.ylabel('validation loss')
plt.legend(fontsize=8); plt.grid(alpha=0.3); plt.tight_layout(); plt.show()

print(f'lr=1e-4 최고 검증 정확도 : {max(h_ft["va_acc"]):.4f}')
print(f'lr=1e-3 최고 검증 정확도 : {max(h_ft_big["va_acc"]):.4f}')
미세조정 lr=1e-3             best epoch  5  val acc 0.8197  (19s, 학습 파라미터 11,177,538)

lr=1e-4 최고 검증 정확도 : 0.9344
lr=1e-3 최고 검증 정확도 : 0.8197

사전학습 가중치는 이미 좋은 자리에 있다. 큰 보폭은 그 자리를 흔들어 놓는다. 미세조정의 학습률은 처음부터 학습할 때의 \(1/10 \sim 1/100\) 로 잡는다.


10. 보고 — 테스트 세트를 여기서 딱 한 번

검증 정확도가 가장 높았던 전략 하나를 고른 뒤, 그 모델로만 테스트한다.

criterion = nn.CrossEntropyLoss()
best_name, best_model = max(
    [('동결', m_frozen), ('미세조정', m_ft), ('처음부터', m_scratch)],
    key=lambda kv: max({'동결': h_frozen, '미세조정': h_ft, '처음부터': h_scratch}[kv[0]]['va_acc']))
print('검증 기준 선택 :', best_name)

te_loss, te_acc = run_epoch(best_model, loaders_aug[2], criterion)
print(f'테스트 손실   : {te_loss:.4f}')
print(f'테스트 정확도 : {te_acc:.4f}')
검증 기준 선택 : 동결
테스트 손실   : 0.2610
테스트 정확도 : 0.9085

10-1. 클래스별로 나누어 보고한다

best_model.eval()
preds, trues = [], []
with torch.no_grad():
    for xb, yb in loaders_aug[2]:
        preds.append(best_model(xb.to(device)).argmax(1).cpu()); trues.append(yb)
preds = torch.cat(preds).numpy(); trues = torch.cat(trues).numpy()

cm = pd.crosstab(pd.Series(trues, name='실제'), pd.Series(preds, name='예측'))
cm.index = raw.classes; cm.columns = raw.classes
print(cm, '\n')
for i, name in enumerate(raw.classes):
    m = trues == i
    print(f'{name:6s}  {m.sum():3d}장 중 {int((preds[m]==i).sum()):3d}장 정답  ({(preds[m]==i).mean():.3f})')
      ants  bees
ants    67     3
bees    11    72 

ants     70장 중  67장 정답  (0.957)
bees     83장 중  72장 정답  (0.867)
정확도 하나만 보고하지 않는다 (Ch04·Ch08)

직접 촬영한 데이터는 클래스별 장수가 고르지 않기 쉽다. 소화기 120장, 소화전 30장으로 학습했다면 전부 “소화기”라고만 답해도 정확도는 80%다.

클래스별 장수를 먼저 밝히고, 클래스별로 몇 개씩 맞혔는지까지 함께 보고한다. 프로젝트 발표에서도 같은 형식을 요구한다.

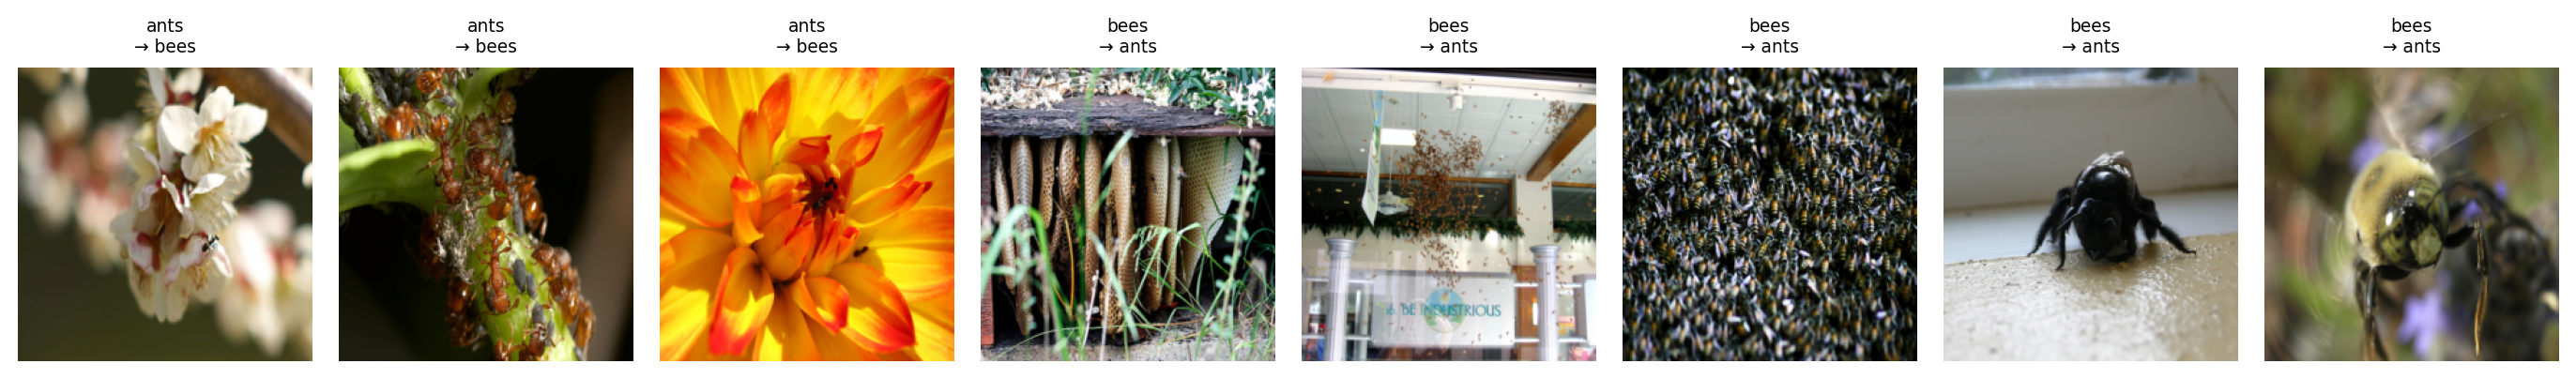
10-2. 틀린 사진을 직접 본다

wrong = np.where(preds != trues)[0][:8]
if len(wrong) == 0:
    print('틀린 사진이 없다.')
else:
    fig, axes = plt.subplots(1, len(wrong), figsize=(1.8*len(wrong), 2.4))
    axes = np.atleast_1d(axes)
    for ax, w in zip(axes, wrong):
        img, _ = test_ds[int(w)]
        ax.imshow(unnorm(img)); ax.axis('off')
        ax.set_title(f'{raw.classes[trues[w]]}\n→ {raw.classes[preds[w]]}', fontsize=7)
    plt.tight_layout(); plt.show()

직접 해보기 ③ — 사진을 절반만 쓰면

훈련 사진을 절반(약 91장) 으로 줄여 동결 전이학습을 다시 하고, 검증 정확도를 비교하시오. 특성 캐싱을 쓰면 몇 초면 끝난다. 데이터가 절반이면 성능은 얼마나 떨어지는가?

half = None                # ← Ftr, ytr 의 앞 절반만 잘라내세요
_, acc_half, _ = fit_head(...)

print('전체 183장 : 검증 정확도', round(acc_cached, 4))
print('절반  91장 : 검증 정확도', round(acc_half, 4))
정답 코드 보기
for n in [30, 60, 91, 183]:
    _, acc_n, _ = fit_head(Ftr[:n], ytr[:n], Fva, yva)
    print(f'훈련 {n:3d}장 → 검증 정확도 {acc_n:.4f}')
훈련  30장 → 검증 정확도 0.9016
훈련  60장 → 검증 정확도 0.9672
훈련  91장 → 검증 정확도 0.9672
훈련 183장 → 검증 정확도 1.0000

동결 전이학습은 학습 파라미터가 1,026개뿐이라 데이터가 적어도 잘 버틴다. 프로젝트에서 클래스당 80장으로 시작할 수 있는 근거가 이것이다.

성능을 올리는 가장 빠른 길은 틀린 사진을 직접 보는 것이다. 어두운 사진이 몰려 틀리는지, 특정 각도가 문제인지가 여기서 드러난다. 프로젝트의 1차 진단에서 그대로 하게 될 작업이다.


11. 정리

이번 주 체크포인트
하고 싶은 일 코드
사진 폴더 → 데이터셋 datasets.ImageFolder(root, transform=tf)
크기 맞추기 transforms.Resize((224, 224))
ImageNet 정규화 Normalize((0.485,0.456,0.406), (0.229,0.224,0.225))
증강 (훈련에만) RandomResizedCrop, RandomHorizontalFlip, ColorJitter
사전학습 모델 models.resnet18(weights=ResNet18_Weights.IMAGENET1K_V1)
동결 for p in m.parameters(): p.requires_grad = False
분류기 교체 m.fc = nn.Linear(m.fc.in_features, n_classes)
학습 대상만 최적화 Adam([p for p in m.parameters() if p.requires_grad], lr)
특성만 뽑기 m.fc = nn.Identity() + @torch.no_grad()
미세조정 학습률 처음부터 학습할 때의 \(1/10 \sim 1/100\)

전략 선택 기준 (Ch08)

상황 전략
내 사진 수백 장 동결 — 과적합 위험 최소
수만 장 이상, 사전학습 도메인과 다름 전체 미세조정 (작은 학습률)

프로젝트는 클래스당 80장 내외로 시작한다. 표의 첫 줄에 해당한다 — 동결이 기본값이다.

스스로 확인해 보기

아래 결과를 먼저 예상한 뒤 실행해서 대조한다.

m = models.resnet18(weights=None)
print('원래 fc :', m.fc)

for p in m.parameters(): p.requires_grad = False
m.fc = nn.Linear(512, 5)

total = sum(p.numel() for p in m.parameters())
train = sum(p.numel() for p in m.parameters() if p.requires_grad)
print('\n전체     :', f'{total:,}')
print('학습 대상:', f'{train:,}', ' (= 512*5+5 =', 512*5+5, ')')
print('비율     :', f'{100*train/total:.4f}%')

# 분류기에 은닉층을 하나 넣으면?
m.fc = nn.Sequential(nn.Linear(512, 128), nn.ReLU(), nn.Linear(128, 5))
train2 = sum(p.numel() for p in m.parameters() if p.requires_grad)
print('\n은닉층 추가 시 학습 대상:', f'{train2:,}', f' ({train2/train:.1f}배)')
원래 fc : Linear(in_features=512, out_features=1000, bias=True)

전체     : 11,179,077
학습 대상: 2,565  (= 512*5+5 = 2565 )
비율     : 0.0229%

은닉층 추가 시 학습 대상: 66,309  (25.9배)

다음 실습

실습 10: 텍스트를 숫자로 — 토큰화와 임베딩 — 이미지에서 텍스트로 넘어간다. 글자를 숫자로 바꾸는 방법만 새로 배우면, 학습 루프는 그대로다.

객체탐지에 관심이 있다면 심화 자료 실습 9: 객체탐지 — IoU와 NMS도 있다.